当地时间 10 月 7 日,在美国加利福尼亚州奥克兰举行的 SPLASH 2026 大会上,南京大学论文“Automated Debugging of Datalog Programs”荣获 OOPSLA 2026 ACM SIGPLAN 杰出论文奖(Distinguished Paper Award)。论文共同第一作者为硕士生卫佳申、骆葆源,通讯作者为钮鑫涛、左志强老师,全部作者均来自南京大学(计算机软件新技术全国重点实验室)。这是南京大学首次以唯一完成单位获得 ACM SIGPLAN 四大旗舰会议杰出论文奖。
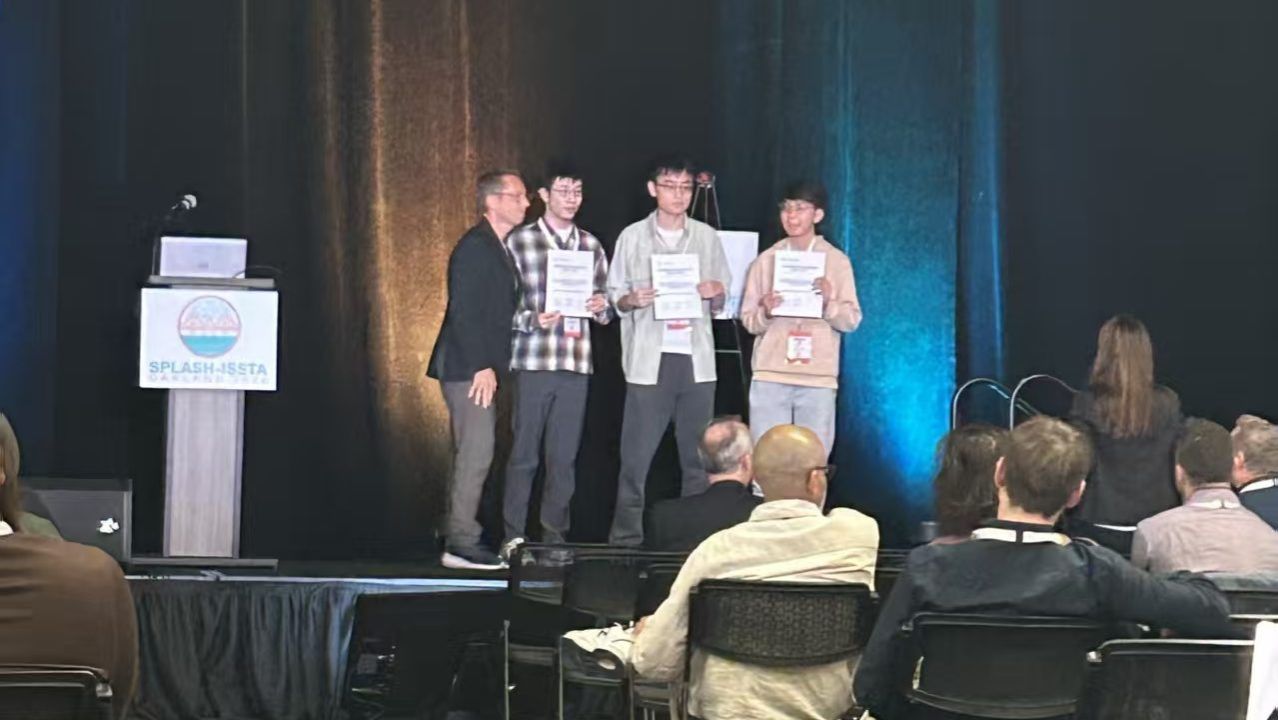
骆葆源、卫佳申、谢润烁在 SPLASH 2026 与 ISSTA 2026 联合颁奖典礼上代表研究团队领奖
OOPSLA(Object-Oriented Programming, Systems, Languages, and Applications)创办于 1986 年,是程序设计语言与软件工程领域的顶级国际会议,与 PLDI、POPL、ICFP 并称 ACM SIGPLAN 四大旗舰会议,也是中国计算机学会(CCF)推荐的 A 类会议,论文发表于 ACM 期刊 PACMPL(Proceedings of the ACM on Programming Languages)。OOPSLA 2026 作为 SPLASH 2026 的核心会议,于 10 月 4 日至 9 日在奥克兰举行,并与 ISSTA 2026 联合举办。杰出论文奖由 ACM SIGPLAN 颁发,由程序委员会从当届录用论文中评选产生,本届共有 6 篇论文获此奖项。
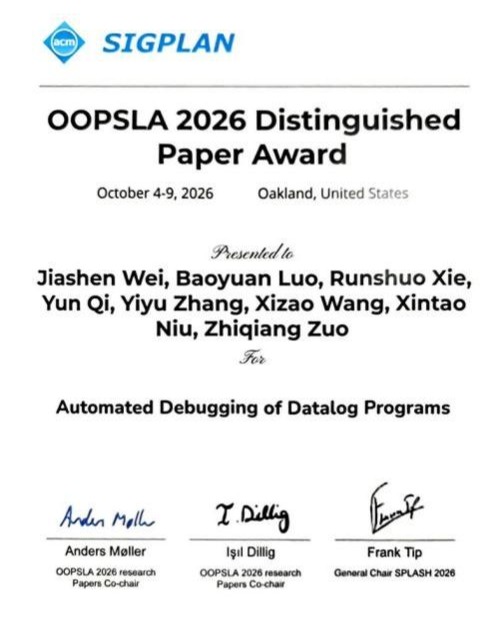
获奖证书
让 Datalog 程序调试走向自动化
Datalog 是一种声明式逻辑编程语言,广泛应用于程序分析、网络验证、大数据分析和安全等领域。以 Java 静态分析框架 Doop 为例,其分析逻辑由数百至近千条 Datalog 规则构成,单个分析配置即可推导出超过 5000 万条事实。与命令式程序不同,Datalog 程序由无序的递归规则组成,没有显式的控制流。一旦推导结果出错,开发者往往只能沿着包含成百上千次规则应用的证明树(proof tree)手工回溯,或在交互式调试器中一步步引导搜索,调试代价很高。
为此,论文提出了一种全自动的 Datalog 程序调试方法,开发者只需确认最终结果,无需逐步引导。研究团队从统计视角重新审视 Datalog 的执行:不再孤立地解释某一条错误事实,而是把每条派生事实看作一个“测试用例”,把其证明树中用到的规则看作这次“执行”覆盖的程序元素,从而将命令式程序中成熟的基于谱的缺陷定位(SBFL)技术迁移到 Datalog 上。缺陷规则往往更多地出现在错误事实的推导中,这种偏斜的参与模式为识别缺陷规则提供了统计信号。在规则级定位的基础上,论文进一步构建“可疑度加权优先图”(SWPG),将规则可疑度沿谓词依赖关系聚合,把缺陷进一步定位到具体谓词。
示例:把派生事实当作测试用例
r5 taint(N2, X) :- taint(N1, X), edge(N1, N2), ¬sanitize(N2, X). 正确
r5′ taint(N2, X) :- taint(N1, X), edge(N1, N2), live(N2, X). 误写
其余规则:r4 由污点源产生 taint;r6、r7 计算控制流图上的可达关系 path。
派生事实 | 标签 | r4 | r5′ | r6 | r7 |
taint(n1, x) | 正确 | ● |
|
|
|
taint(n2, x) | 错误 | ● | ● |
|
|
taint(n3, x) | 错误 | ● | ● |
|
|
path(n1, n2) | 正确 |
|
| ● |
|
path(n2, n3) | 正确 |
|
| ● |
|
path(n1, n3) | 正确 |
|
| ● | ● |
Ochiai 可疑度 | 0.816 | 1.000 | 0.000 | 0.000 |
开发者把“未被净化”(¬sanitize)误写成“变量活跃”(live),污点因此越过净化点,产生 taint(n2, x)、taint(n3, x) 两条错误事实。把每条派生事实当作测试用例、把其证明树用到的规则当作覆盖,r5′ 只参与错误事实的推导,Ochiai 可疑度为 1.000,排在第一位。
为系统评估 Datalog 调试技术,研究团队挖掘了 Doop 的演化历史,构建了据作者所知首个面向 Datalog 调试的真实缺陷基准,共包含 96 个缺陷实例(对应 37 个独立缺陷),每个实例都标注了真实缺陷规则,并按三级缺陷分类体系组织。实验表明,该方法无需任何用户交互即可有效定位缺陷:最优可疑度指标在缺陷规则定位上的 Hit@1(排名第一的候选恰为缺陷规则的比例)达到 87.50%,缺陷谓词定位的 Hit@1 为 37.50%~53.12%;即使检查排名前 10 的候选,开发者也只需查看程序全部规则的约 1%~2%。方法对不完整的事实标注同样稳健:在错误事实不超过 1000 条的实例上,仅标注 10 条错误事实即可达到约 90%~100% 的 Hit@3。整个流程在所有基准实例上的峰值内存低于 27 GB,平均端到端耗时约 8~24 分钟。
论文的研究制品通过了 OOPSLA 制品评估,获得三枚 ACM 制品徽章,基准、实验脚本与原始数据均已在 Zenodo 公开。
报告与领奖
10 月 5 日,论文第三作者、博士生谢润烁在 OOPSLA 的 Debugging and Fault Localization 分会场作论文报告,向与会学者介绍了这项工作。10 月 7 日,SPLASH 2026 与 ISSTA 2026 举行联合颁奖典礼,骆葆源、卫佳申、谢润烁代表研究团队上台领奖。
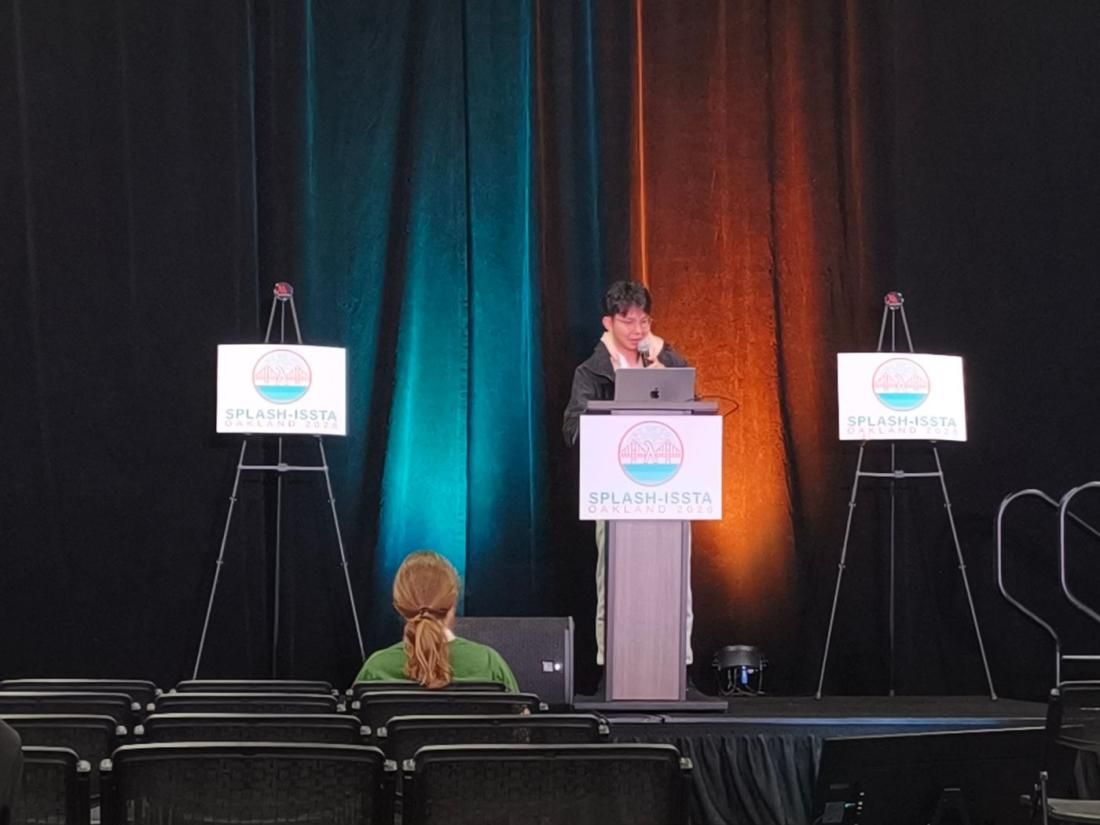
谢润烁在 Debugging and Fault Localization 分会场作论文报告
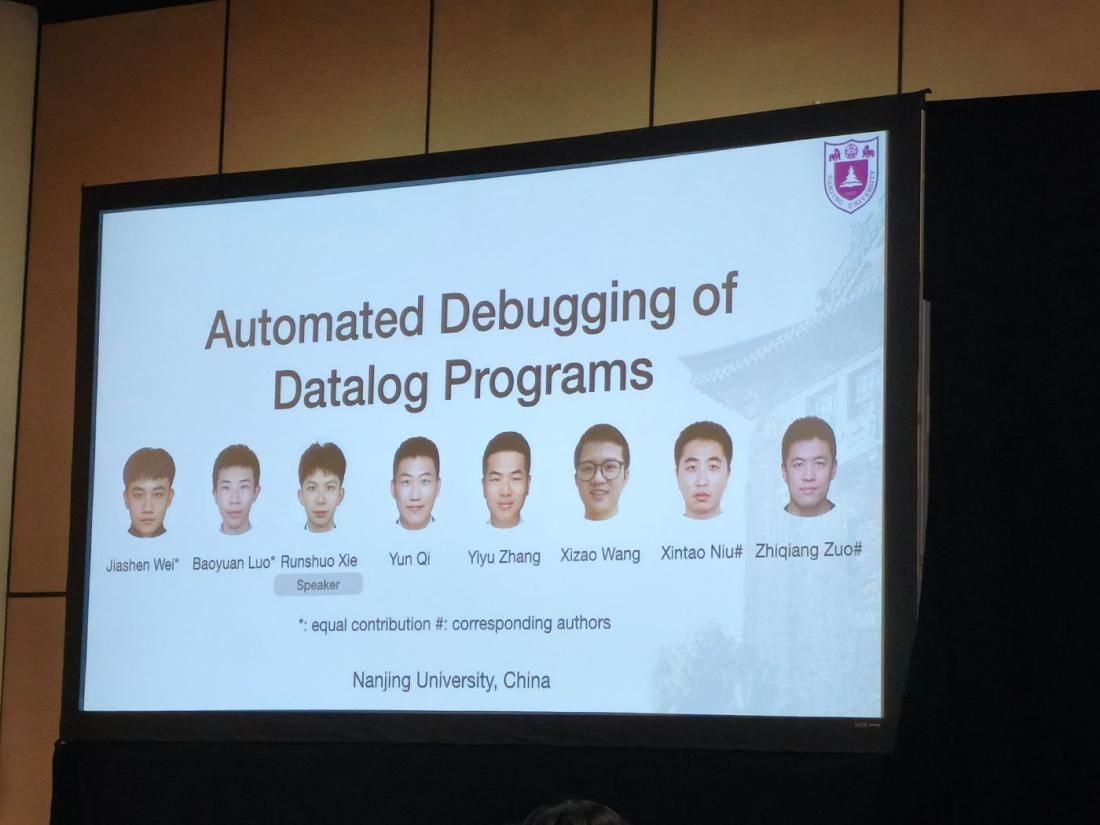
报告首页:八位作者均来自南京大学
一份稀缺的荣誉
据不完全统计,截至 2026 年 10 月,ACM SIGPLAN 四大旗舰会议(PLDI、POPL、OOPSLA、ICFP)自设立杰出论文奖以来共评出 243 篇获奖论文,其中由单一中国大陆单位独立完成的只有 2 篇,本文是其中之一。
四大旗舰会议杰出论文逐层统计
篇数 | 统计范围(每一行都包含在上一行之内) |
243 | 四大旗舰会议历年杰出论文 |
12 | 有中国大陆单位作者参与 |
7 | 第一作者来自中国大陆单位 |
3 | 作者全部来自中国大陆单位 PLDI 2019(中国科学技术大学、南京大学)、OOPSLA 2025(北京大学)、OOPSLA 2026(南京大学) |
2 | 由单一中国大陆单位独立完成 北京大学(OOPSLA 2025)、南京大学(OOPSLA 2026) |
1 | 南京大学独立完成:本文 也是南京大学首次以唯一完成单位获得四大旗舰会议杰出论文奖 |
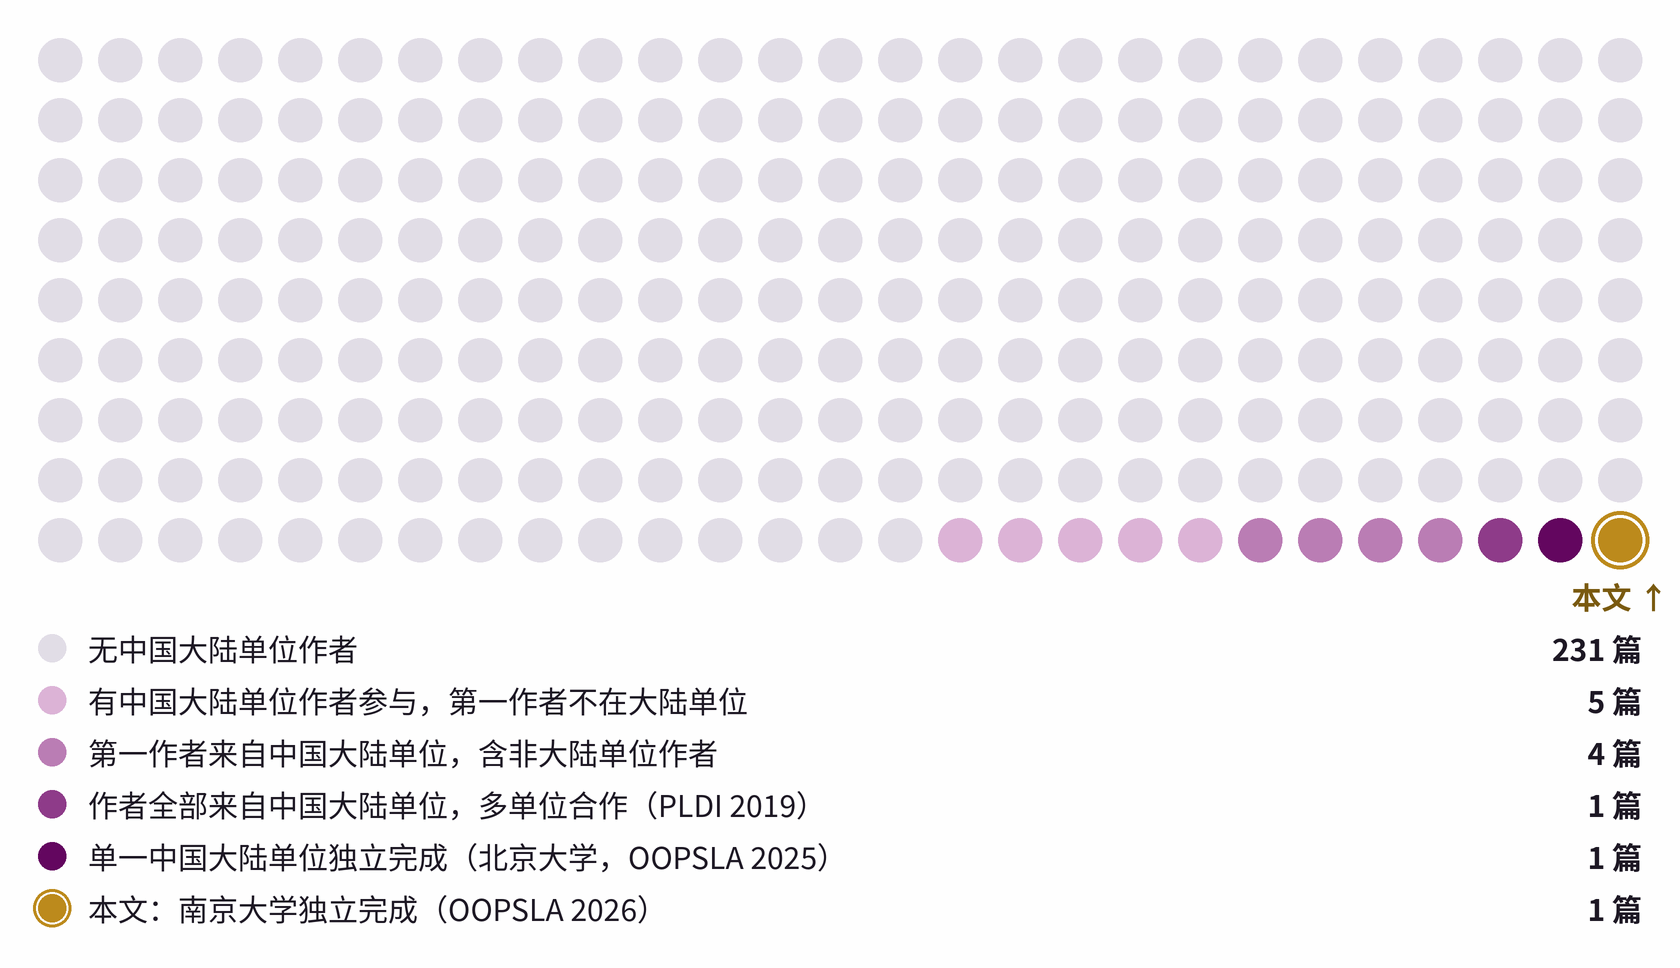
243 篇获奖论文,每个圆点代表一篇,按类别排列
从单个会议看,OOPSLA 自 2013 年起评选杰出论文,至今共约 80 篇论文获奖;2013—2025 年间,第一作者来自中国大陆单位的获奖论文仅 3 篇。本届 OOPSLA 共评出 6 篇杰出论文,南京大学参与完成其中 2 篇;本文也是本届唯一一篇作者全部来自中国大陆单位的获奖论文。
南京大学在四大旗舰会议获杰出论文奖的记录
年份 | 会议 | 完成方式 |
2013 | OOPSLA | 与其他单位合作完成 |
2019 | PLDI | 与其他单位合作完成 |
2020 | OOPSLA | 与其他单位合作完成 |
2026 | OOPSLA | 与其他单位合作完成 |
2026 | OOPSLA | 南京大学独立完成(本文) |
统计说明:依据 PLDI、POPL、OOPSLA、ICFP 自设立杰出论文奖以来的官方获奖名单与论文署名整理,截至 2026 年 10 月。“中国大陆单位”以论文发表时的署名单位为准,不含港澳台地区;个别年份(如 OOPSLA 2014)的获奖名单仅部分可考,统计结果可能存在少量出入。
论文信息
题目 | Automated Debugging of Datalog Programs |
作者 | Jiashen Wei*, Baoyuan Luo*, Runshuo Xie, Yun Qi, Yiyu Zhang, Xizao Wang, Xintao Niu#, Zhiqiang Zuo# * 共同第一作者 # 通讯作者 |
单位 | 南京大学;计算机软件新技术全国重点实验室 |
发表 | Proc. ACM Program. Lang. 10, OOPSLA2, Article 384 (October 2026) |
DOI | https://doi.org/10.1145/3839516 |
研究制品 | https://doi.org/10.5281/zenodo.21394682 ACM 徽章:Available · Reusable · Reproduced |
资助 | 江苏省基础研究计划(BK20250067)、国家自然科学基金(62272217)、教育部基础学科和交叉学科突破计划(JYB2025XDXM118)、高等学校学科创新引智计划(B26023) |


 English